两个人同时讲话,两个麦克风各录到一段混合声音。如果不知道说话人的位置,也不知道声音从嘴到麦克风经历了怎样的传播,能否只靠这两路录音找回各自的语音?这就是盲源分离要解决的问题。“盲”不是完全没有条件,而是不预先知道源信号和混合通道;能否分开,仍取决于麦克风数量、混合方式和对声源所作的统计假设。
我更愿意从一个可以算清楚的模型入手,再看它在真实录音里哪里失效。否则,直接把 ICA、IVA、ILRMA 排成一串算法名称,很容易以为它们只是求解器从慢到快的替换;实际上,模型假设也在变化。
两路录音为何有可能分开
先不考虑传播延迟与混响。设两个源信号为 ,两个麦克风的观测为 ,则瞬时线性混合可以写成
的每一列描述一个声源对两个麦克风的贡献。若 已知且可逆,直接求 就可以恢复源信号;盲源分离难在 和 都未知。我们只能从观测中估计解混矩阵 ,使 的两个分量尽量各自对应一个声源。
从几何上看,解混矩阵中取出第一个声源的那一行,应当压制第二个声源的混合向量;即 。另一行同理。但只凭“找一条垂线”无法确定正确的方向,因为 本身就是未知的。真正提供额外约束的是源信号之间的统计独立性。
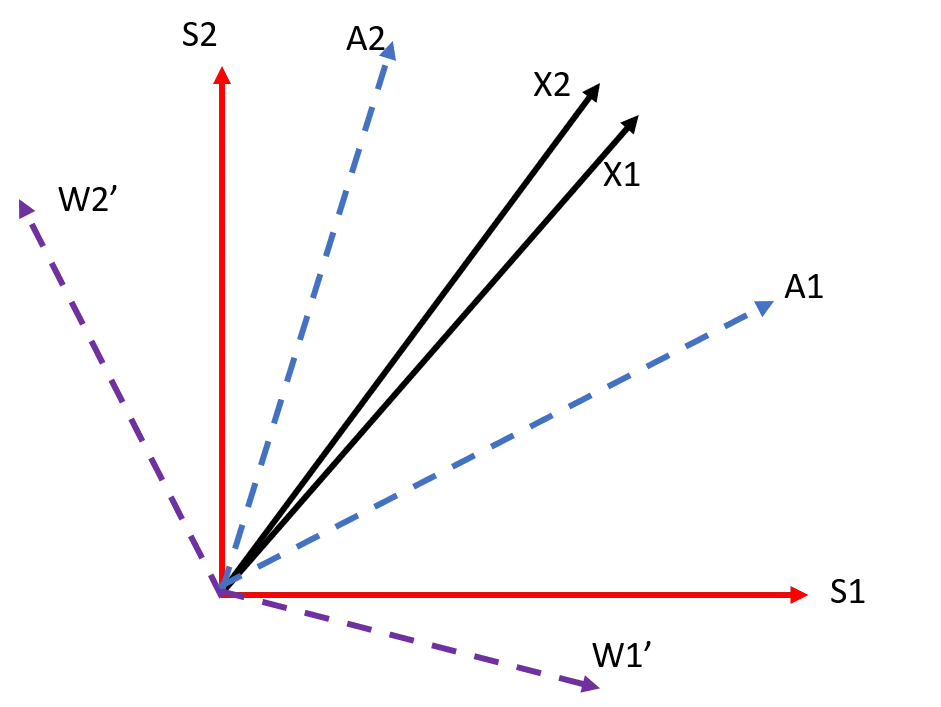
图中的两条蓝色方向表示源信号经过混合矩阵后在观测平面中的方向,紫色方向表示用于压制另一声源的解混方向。它是瞬时混合的几何示意,不代表真实房间中的传播路径只有两个固定系数。
这个简化模型有几条不能略去的前提:声源数量不超过麦克风数量;方阵情形下 满秩;不同源在统计上足够独立;经典 ICA 的可辨识条件还要求至多只有一个高斯源。两个高斯源即使已经白化,仍可能在旋转后保持同样的联合分布,单靠独立性无法确定原来的方向。分离结果还天然带有顺序和尺度不确定性: 可以是一个置换矩阵与对角缩放矩阵的乘积,不必等于单位阵。输出先后互换、整体变号或响度变化,不意味着分离失败。
从白化走到 ICA
计算时通常先把观测减去均值,再对白化后的数据寻找独立方向。若中心化观测的协方差分解为
则 。白化消除了二阶相关,但不等于找到了独立成分;非高斯源的高阶统计结构仍可用于确定旋转方向。也可以从极大似然理解这个过程:在无噪声可逆模型下,若各个估计源的密度为 ,单个样本的观测密度为
这里的 来自变量变换的雅可比行列式,不能省略。不同的源分布假设会产生不同的对比函数;并不存在一个对所有语音场景都最合适的固定分布。FastICA 则常用非高斯性近似构造定点迭代。在已白化、已归一化的条件下,一行权向量的一种更新形式是
取 后,还需对多行权向量做正交化,避免两行都找到同一个成分。它在瞬时、方阵、源分布合适的实验中很方便,但并没有替我们处理房间反射。
一个可以复现的双通道实验
先用两路相互独立、非高斯的随机信号做源。这里不把它们冒充语音;它们只是用来检验:当 ICA 的前提确实成立时,解混是否能找回独立成分。以下代码只依赖 NumPy,包含中心化、白化、对称 FastICA,以及对尺度和排列不敏感的相关性检查。
import numpy as np

rng = np.random.default_rng(28)
n = 20000
s = np.column_stack((
    rng.laplace(size=n),
    rng.uniform(-np.sqrt(3), np.sqrt(3), size=n),
))
s = (s - s.mean(axis=0)) / s.std(axis=0)

# 两个声源、两个观测通道;行是麦克风,列是声源。
a = np.array([[1.0, 0.65], [0.35, 1.0]])
x = s @ a.T
xc = x - x.mean(axis=0)

def symmetric_decorrelation(w):
    d, u = np.linalg.eigh(w @ w.T)
    return (u @ np.diag(1.0 / np.sqrt(d)) @ u.T) @ w

# 行向量样本写法:z = xc @ whitening.T。
d, u = np.linalg.eigh((xc.T @ xc) / n)
whitening = u @ np.diag(1.0 / np.sqrt(d)) @ u.T
z = xc @ whitening.T
w = symmetric_decorrelation(rng.normal(size=(2, 2)))

for iteration in range(1000):
    y = z @ w.T
    g = np.tanh(y)
    gp = 1.0 - g**2
    new_w = (g.T @ z) / n - np.diag(gp.mean(axis=0)) @ w
    new_w = symmetric_decorrelation(new_w)
    change = np.max(np.abs(np.abs(np.diag(new_w @ w.T)) - 1.0))
    w = new_w
    if change < 1e-8:
        break

estimated = z @ w.T
correlation = np.corrcoef(s.T, estimated.T)[:2, 2:]
print("iterations:", iteration + 1)
print("absolute correlation:\n", np.round(np.abs(correlation), 3))
这组固定随机种子的数据运行 4 次迭代后,相关矩阵的绝对值约为 。观察这个 矩阵:若每行、每列各有一个接近 1 的元素,就说明输出在允许换序、反号和缩放后接近原始源。相关性只是这个受控实验的检查手段,不能代替真实录音的听感或干扰抑制评价。若把两列混合向量调得几乎平行, 会病态,分离对噪声和数值误差就会更敏感;若把源都改为高斯信号,ICA 的可辨识依据又会消失。这两项改动比单纯调整迭代次数更能说明模型的边界。
要把实验换成实际语音,至少准备两段同采样率、单声道、长度一致的干净录音,先作为 人工构造双通道混合,再核对算法能否恢复。这个实验仍是“真实语音、人工瞬时混合”,不是“真实房间双麦录音”。评测时应在最佳源排列下比较结果,明确是否允许尺度校正,并同时听目标语音残留、串音与失真;仅看输出波形或某个相关系数不够。
为什么把代码直接用于房间录音会失效
真正的麦克风观测包含传播时延和多次反射,更接近卷积混合:
这里 是从第 个声源到第 个麦克风的房间脉冲响应, 是噪声。瞬时 ICA 只有一个固定矩阵 ,无法同时消除各个延迟上的混合。一个常见做法是做短时傅里叶变换,在每个频点近似写成 ,再估计频率相关的 。这个近似还依赖分析窗、混响长度等条件,不能把时域卷积无条件地当作逐频点乘法。
如果每个频点独立运行 ICA,就会产生频率置换问题:同一说话人在低频可能位于输出 1,在高频却位于输出 2,合成回时域便拼不成完整的一路语音。IVA(独立向量分析)把同一输出通道在多个频点的系数视作一个源向量,利用频率之间的统计依赖来联合确定排列。它的重点不是“把 ICA 的源分布换成拉普拉斯分布”,而是用跨频点的联合源模型替代各频点互不相干的源模型。例如一种多变量超高斯先验可以写作
根号里跨频点求和,正是它不同于“每个频点各自用一个拉普拉斯先验”的地方。AuxIVA 在相同一类目标函数上引入辅助函数来更新解混矩阵,改进的是优化过程,并没有让源模型的选择不再重要。
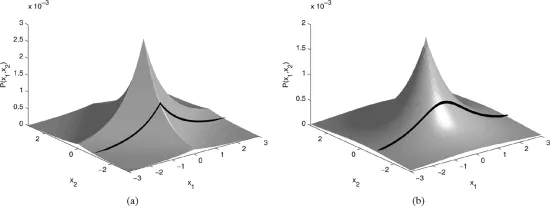
左图把两个分量分别建模,右图允许它们存在依赖;即使单看某个分量的分布相近,条件分布仍可能不同。这正是联合源模型能够利用、逐频点独立建模会丢掉的信息。图据 Kim 等人的联合频率依赖研究。
再往前一步,ILRMA(独立低秩矩阵分析)让每个源的时频功率具有低秩结构,常写成
描述频谱基, 描述随时间变化的激活;空间解混与源功率模型交替估计。相比只用一个跨频点能量刻画某帧,时频方差可以表达更细的语音结构,但增加参数后也可能带来局部极值、计算成本和模型失配。低秩分解不是保证效果提升的开关,更不能简单推出“ILRMA 只能离线运行”;在线或分块处理需要另外设计状态更新与稳定性约束。
若要在双麦录音上复现这条路线,输入应是一段同步录制的双通道 WAV,而不是把两段单声道录音分别当成两个麦克风。对两路信号采用同一窗函数与步长做 STFT,得到形状为“时间帧 × 频点 × 麦克风”的观测;在每个频点估计解混矩阵,并按源模型更新权值;统一各频点输出的尺度后,使用与分析窗匹配的合成窗逆变换,得到两路语音。可以从 Pyroomacoustics 的 AuxIVA 参考实现 核对数据维度、跨频点权重、回投影和重建步骤。真实数据要逐项检查双通道是否同步、是否有削波、语音活动是否足够,以及短时窗相对于混响长度是否合适;只看算法返回了两条波形,并不能确认它们已经分开。
真正做双麦实验时怎么排查
我会先确认问题属于哪一种混合,再选算法,而不是先跑一个名字最熟悉的实现。
| 观察条件 | 合适的起点 | 首先检查什么 |
|---|---|---|
| 人工瞬时混合、两源两通道 | ICA / FastICA | 独立性、混合矩阵条件数、尺度与排列 |
| 房间双麦、两位说话人 | 频域 IVA / AuxIVA | 跨频点排列、混响长度、收敛与回投影 |
| 源具有较稳定的时频低秩结构 | ILRMA | 秩数、源模型是否贴合、计算量 |
| 声源多于麦克风,或强噪声、强混响 | 不再套用上述方阵模型 | 是否需要稀疏、空间、学习式先验或额外通道 |
实验记录至少要留下采样率、麦克风间距、源与麦克风位置、房间混响、输入信噪比、STFT 窗长与步长、迭代停止条件。评测最好分别看目标保真、残余干扰和伪影:有干净参考时,可按最佳排列计算 SI-SDR 等指标;没有参考时,保留原始双通道录音和可复听的分离结果,并比较目标字词可懂度、串音和语音自然度。对频域算法,还应先做尺度回投影,再比较输出响度与波形,避免把任意缩放误认为性能差异。
盲源分离最有意思的地方,并不是求出一个漂亮的解混矩阵,而是看清哪些信息让源变得可辨识。在受控瞬时混合中,独立性足以提供方向;进入房间以后,还要处理时间延迟、频率排列和源的时频结构。实践里每增加一层复杂性,都应对应一项明确的模型变化和一组能检验它是否奏效的实验。
延伸阅读
- Hyvärinen 与 Oja:Independent Component Analysis: Algorithms and Applications:ICA 的模型、可辨识性与算法基础。
- Kim、Eltoft 与 Lee:Independent Vector Analysis:将跨频点依赖纳入源向量建模。
- Ono:Stable and Fast Update Rules for Independent Vector Analysis:AuxIVA 的辅助函数更新。
- Kitamura 等:Determined Blind Source Separation Unifying IVA and NMF:ILRMA 的原始论文与作者实现入口。
- Le Roux 等:SDR — Half-Baked or Well Done?:理解分离评测中尺度处理的差异。
交流与讨论
评论加载中…