电话开着免提,对方的话从扬声器出来,绕过桌面和墙壁,又回到麦克风里。如果这时我也开口,麦克风收到的就是两个人的声音。把整段音量调小,两边都会安静。可电话另一头的人,是想听清我刚才说了什么。
我做 SoundField,最先要回答的就是这个问题。它是我个人创建和维护的 Python 语音信号处理库。回声消除、阵列拾音、声源分离和去混响各有自己的入口。我把它们放在一起,是因为同一段麦克风录音经过几级处理之后,常常得回到最初那句话上,听一听、算一算,它究竟还剩下多少。
先把扬声器那一路接进来
对第 支麦克风,我把收到的信号写成
是送往扬声器的播放信号, 是播放到采集之间的延迟。房间和设备对声音的影响放在 里。我要保留的近端声音是 ,其余噪声记作 。有了播放参考,滤波器可以估计回到麦克风的那部分声音,再从 里减掉它。近端说话人没有给我一条单独的参考信号,这正是双讲比远端单讲难的地方。
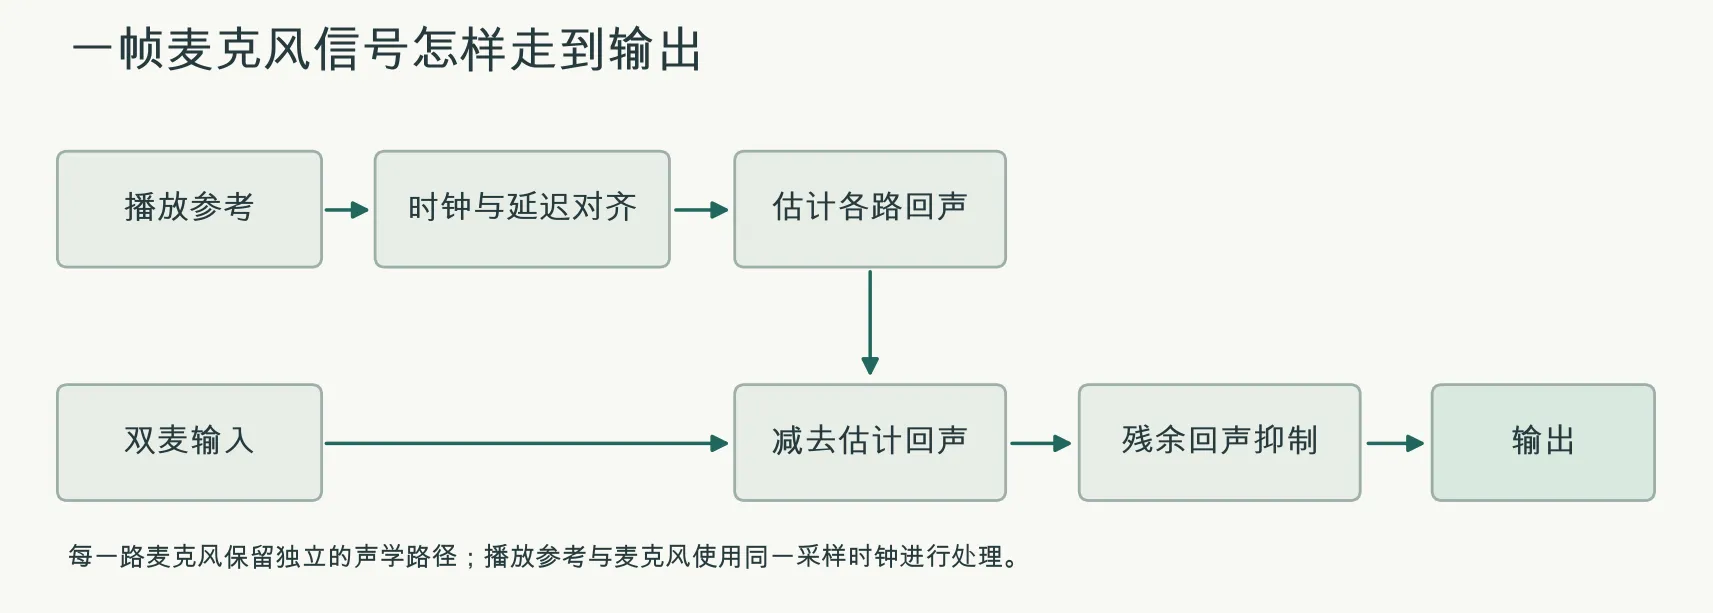
有个数很容易在接口里丢掉。一段 16 kHz 的仿真给播放链加了 2,750 个采样的延迟,大约 172 ms。算法按 512 个采样处理一块,相当于 32 ms。假如上层每次只交来 373 个采样,一个声学事件在第几个输入块里,随切块方法就会变;它在录音的第几个采样,却是确定的。所以我的流式入口接收样本时间戳,块的末尾可以停在任意位置,结束时用一次 flush() 取回尾部。
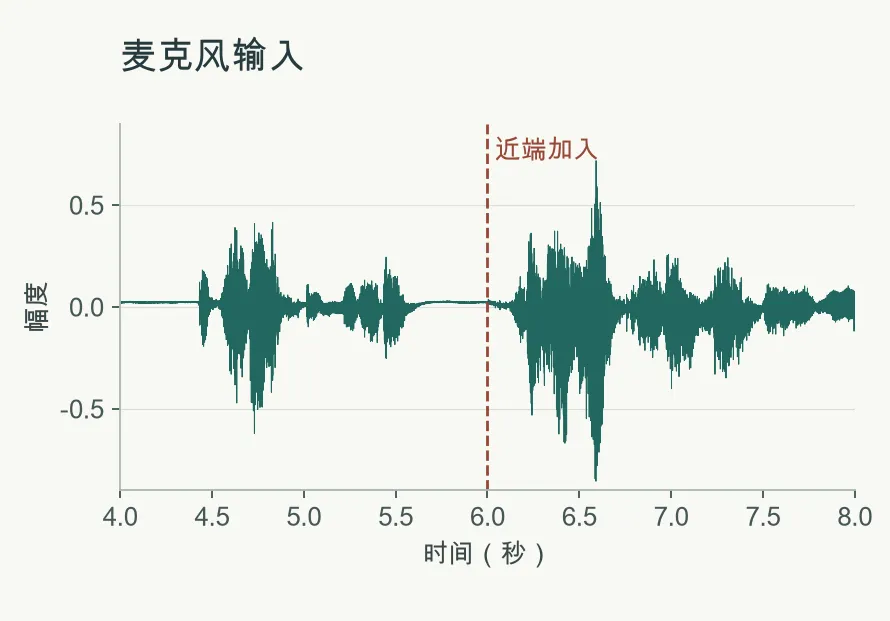
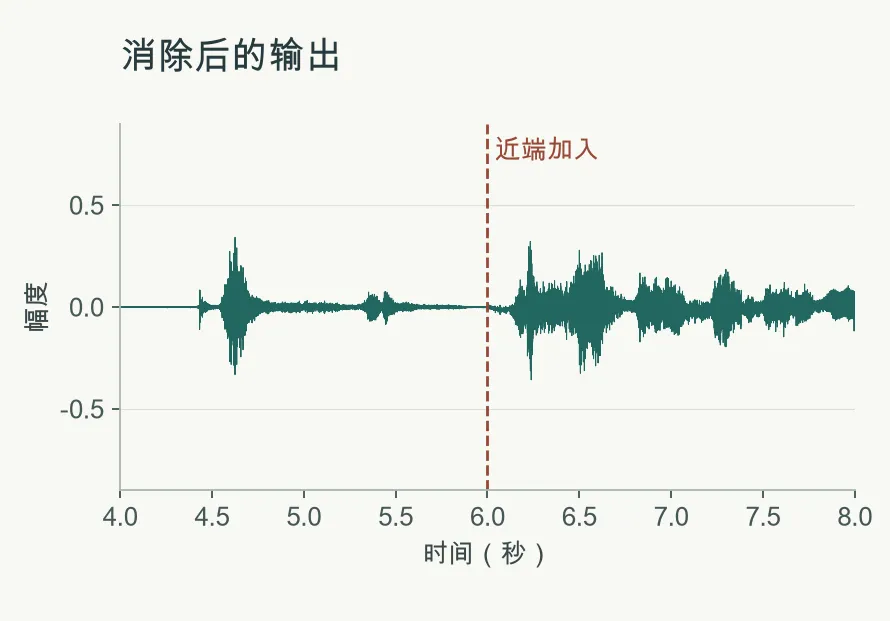
下面两张波形来自同一段模拟通话的第一支麦克风。左边是麦克风输入,右边是消除后的输出。我特意把第 6 秒放在图里,因为近端正是在这里加入。第 6 秒之前可以看远端回声有没有压下去;第 6 秒之后,输出里本来就应该有声音。
把同一段放到频谱上,事情会清楚一点。下面各图都是 16 kHz 音频,用 512 点 Hann 窗、256 点帧移;横向位置相同就是同一时刻,同一种颜色代表相同的幅度。两张图若分别按照自己的最大值上色,已经压低的回声会被重新画得很亮,看图的人很容易得出相反的结论。
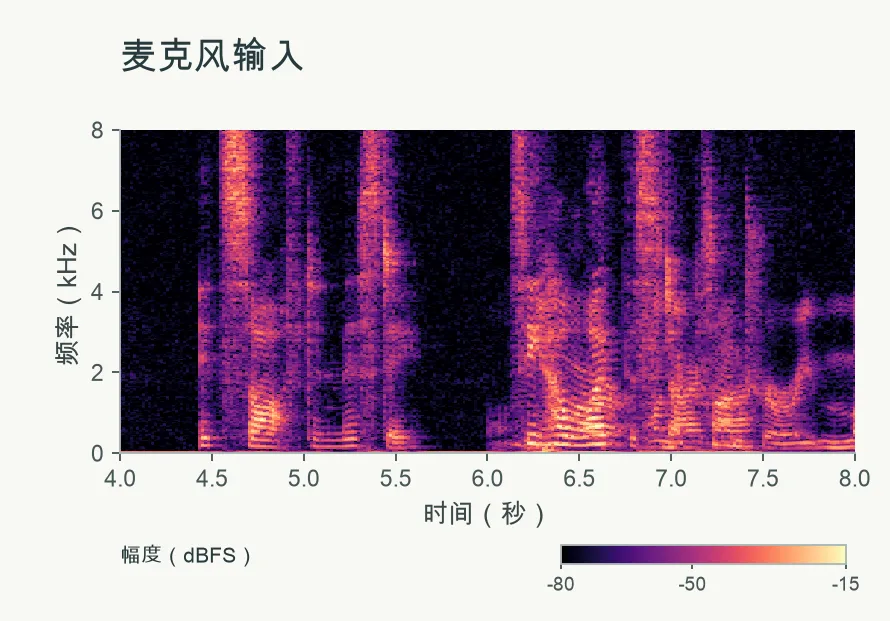
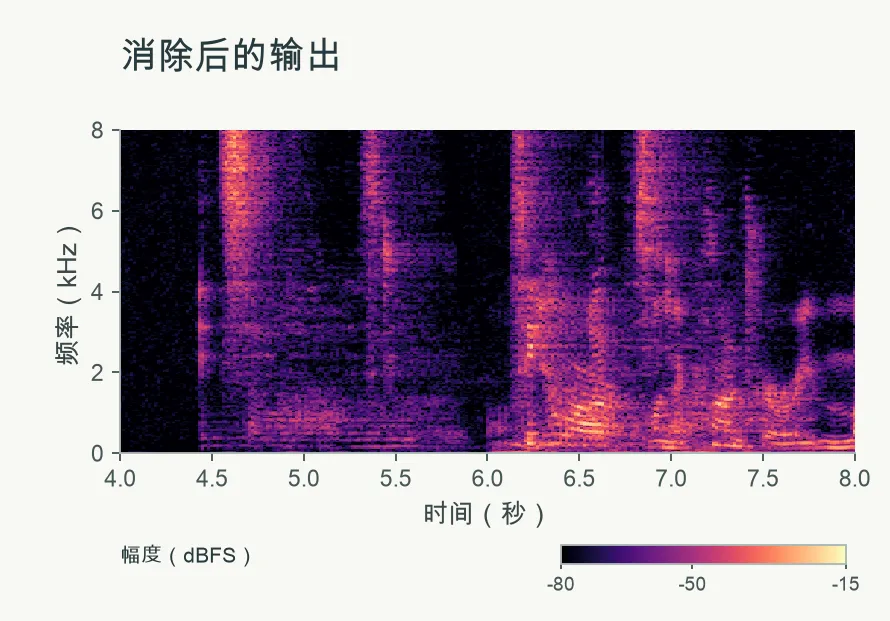
我会把远端单讲与双讲分开算。单讲时看回声回损增益(ERLE),即回声输入能量与输出残留能量之比,取分贝;双讲时把输出与已知的近端声像比较,加一道近端失真门槛。仿真里还可以在第 10 秒换一条反射路径,同时让音频短缺一块。六个房间、每房五种条件,用远端回损至少 8 dB、双讲近端 SDR 至少 3 dB、恢复时间至多 2.5 秒一起算,30 条里有 27 条达标。换到另外六个混响更长的房间,只剩 16 条。两个数字我都保留。房间一换,同一套参数能做到哪里,也就有了边界。
两支麦克风,听得出方向,也会跟丢人
两支麦克风之间有一段距离。同一个声波从不同方向过来,到达两支麦的时刻会有差别。在频率 上,一段时差 对应的相位差大小就是 。阵列把各个频带的观测和候选方向的相位关系比较,能够得到方向证据。到了低频,两种方向的相位差可能小得分不开;有反射时,最强的到达方向也不一定就是人的方向。
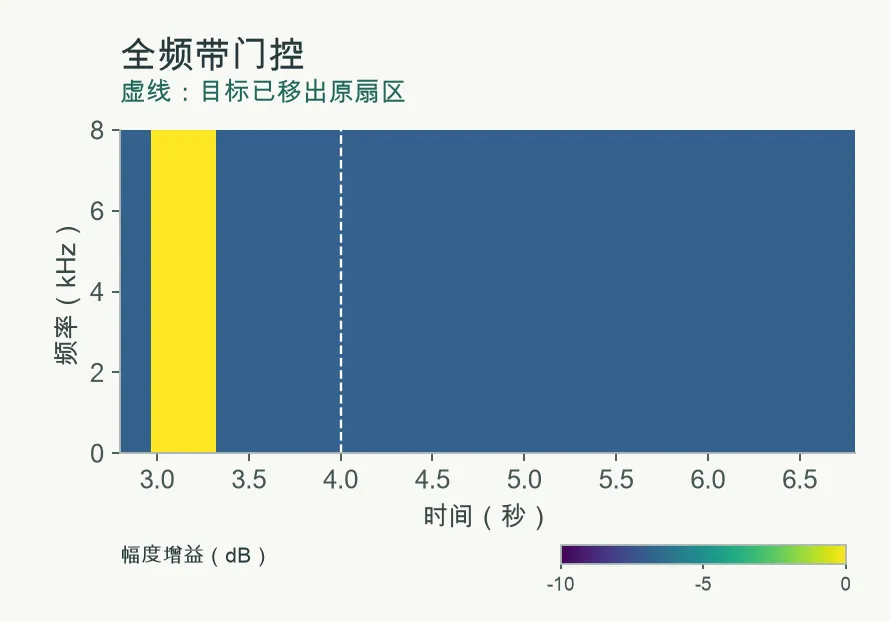
我在定向拾音里遇到过一个很具体的问题。波束朝着 90°,把它左右各 15° 作为目标扇区。人说着话移到 135°,旧扇区里的票数就掉下去了。此时如果把整帧乘以 0.45,凡是和目标一起落在这一帧里的频带,都要一起损失约 6.9 dB。人还在说,门已经关了。
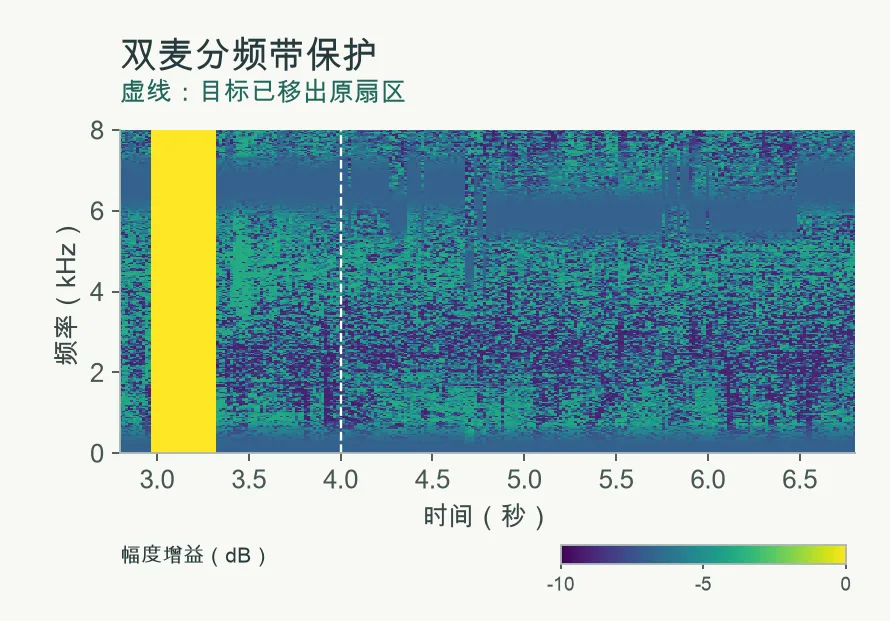
现在的双麦模式会在门关闭时多看一步。对于确实能区分目标和持续干扰方向的频带,让增益随两路相位证据调整。六个房间的目标越界场景,语音 SDR 中位数从 6.96 提到 7.53 dB,干扰衰减从 3.77 变为 3.62 dB。这一点改善是用少量干扰衰减换来的,离我设的 12 dB 人声保真线还有距离。调用方如果有随时间更新的目标方位,就应该逐帧传进来。单凭两支麦克风,我不能把一个从旧方向消失的人认作新方向上的某一个人。
下图画的是增益本身。横贯所有频率的一条暗带,就是整帧一起关门;右图在同一时刻还能看到不同频带受到了不同程度的衰减。虚线处,人已移出原扇区。两种算法收到的是同一份混合信号。
当两个人都要留下来
通话只想留近端时,参考播放信号很有用。可一段双人录音里,两个说话人都要留下来,我手里又没有任何一个人的干净参考。这就轮到盲源分离了。
我的整段双麦模式先把两路录音变成频谱,再为每个频点拟合一个解混矩阵。它用两路观测之间的差别估计两个声源,把输出映射回参考麦克风的尺度。下面是同一段双人混合录音和其中一路分离结果。第二个人开口时,第一路里依然可能漏进他的声音,所以我还会拿两人的已知声像分别算串音。文件变成了双通道,还不能据此认定每人已经各占一路。
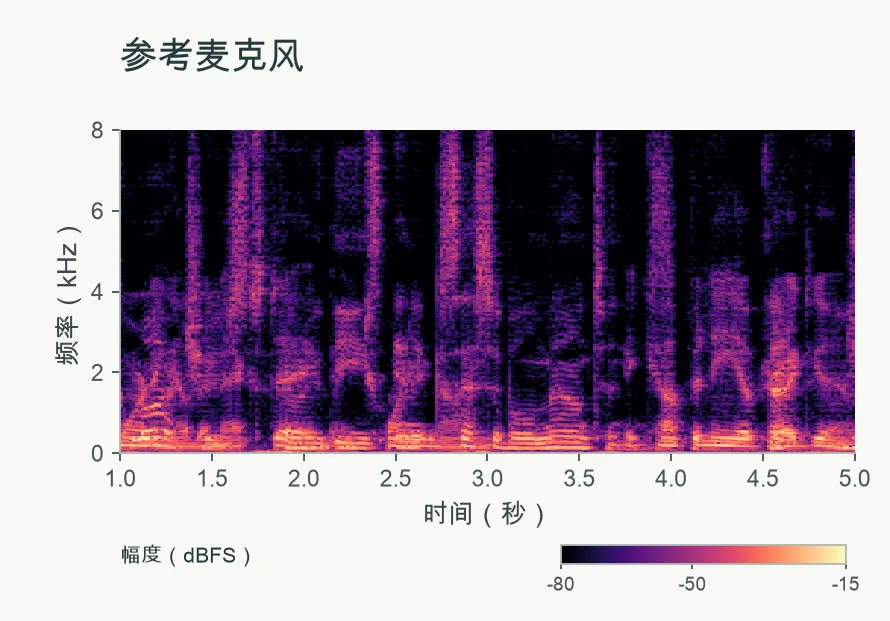
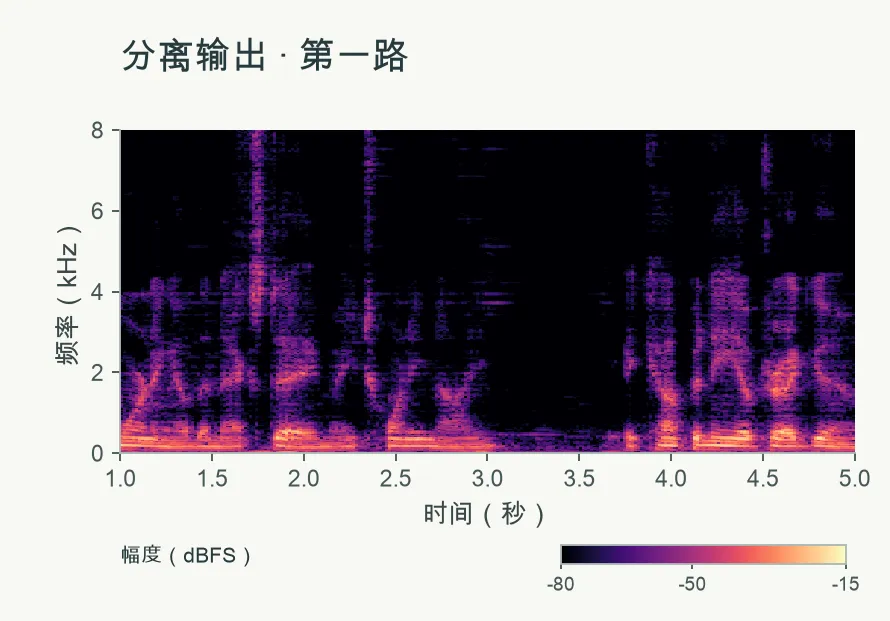
这里有两个接口值得分开。整段拟合需要先拿到整份录音,适合会后处理;要边采边出声,可以使用逐帧更新的分离器。如果录音里还有扬声器播放,我会先用同步播放参考做回声消除,再分离两位说话人,最后在已经分开的声像上估计剩余的播放泄漏。为了给近端人声留余地,最后这一步只减去估计量的一半。
同一个算法看两个指标,结果可以相差不少。在八类双麦场景里,这一步让输出中与播放相关的残留降低了 4.63–5.23 dB,但两位说话人的 SI-SDR 改善只有 0.12–0.29 dB。前者只看还漏进来多少播放声,后者还把另一位说话人的串音和分离失真都算进去了。
房间的尾巴,要减到哪里
人停下来说话,房间还会响一会儿。WPE 去混响用较早的多通道频谱预测当前帧里迟到的那部分,再把预测量减掉。我在预测器和当前帧之间留出一段间隔,让它少碰直达声和紧跟在直达声之后的早期反射。整段模式可以补偿预测器的输出延迟,这样处理前后的同一个时刻才对得上。
下面这个长混响房间里,我让干声在第 5 秒停下。左边还挂着一段逐渐变暗的尾音,右边是相同麦克风经过 WPE 的结果。这里有意设置的停顿给了我一个可以量尾音的窗口。实际运行的预测器只拿到麦克风输入,不知道干声在哪个采样停下。
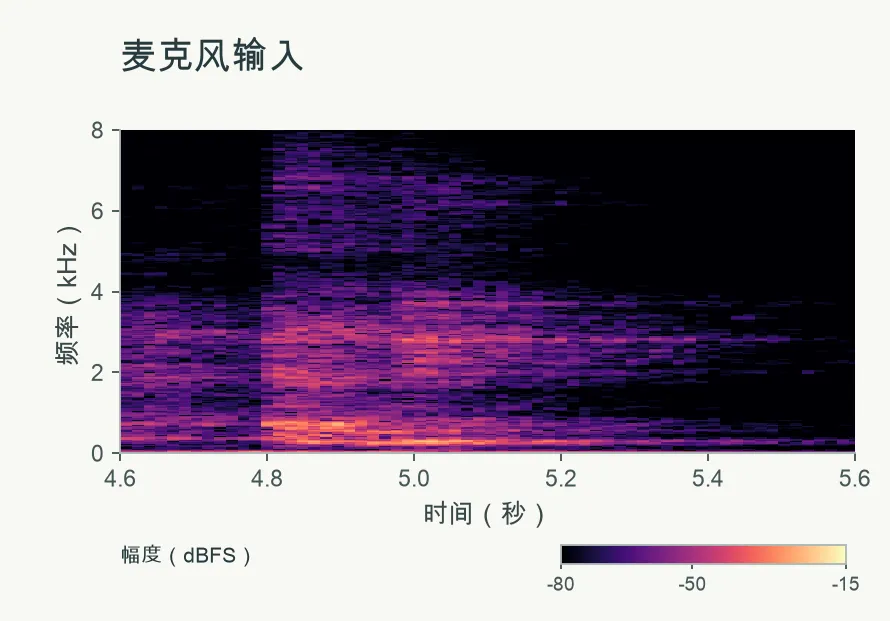
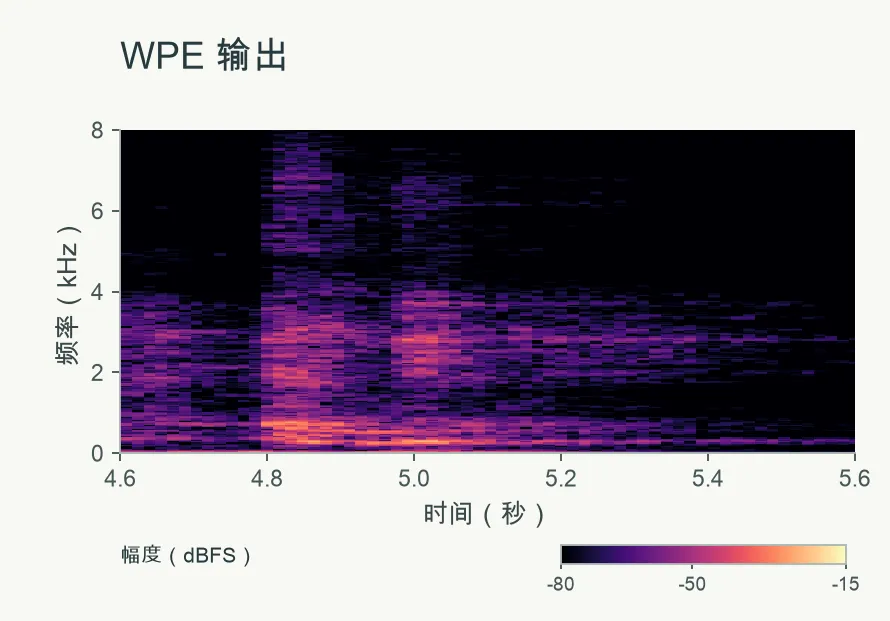
到了短混响,我会反过来问,预测器还有多少东西值得减。六个房间里,低延迟 WPE 在长混响下相对旁路改善了 3.96 dB,短混响下却下降了 2.40 dB。我的整段保护模式会检查双麦的一致性,也看录音里是否多次出现很快的自然衰减。证据足够时,响亮的早期语音多留一些,低能量尾部继续处理。仅凭两路信号很像就关闭预测,会误伤一种常见输入:同一条有混响的录音被复制到了左右两个通道。
要对一份 16 kHz 双麦录音试这条路径,只需要把两个通道放在同一个数组里。下面的 audio 形状为 (采样数, 2),返回的样本数与输入相同。
from soundfield.dereverb import WpeConfig
from soundfield.pipelines import reduce_reverberation

output = reduce_reverberation(
    audio, WpeConfig.low_latency(),
    compensate_delay=True, protect_short_decays=True, sample_rate_hz=16000,
)
最后拿一句话听听
我也用语音活动检测(VAD)和识别(ASR)检查前端。它们在这里各回答一个小问题:一句话从哪里开始、在哪里结束,以及剩下来的信号还能不能认出原来的字。
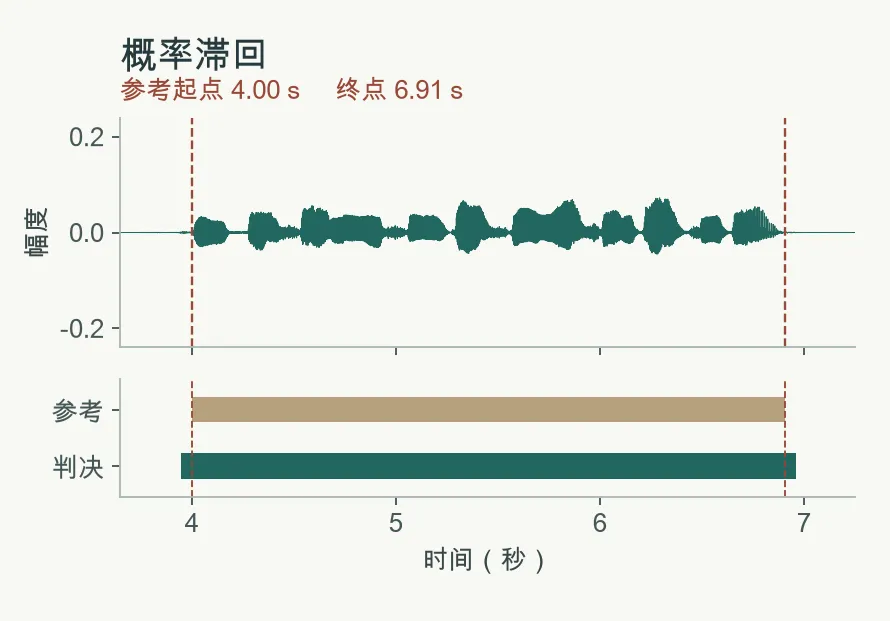
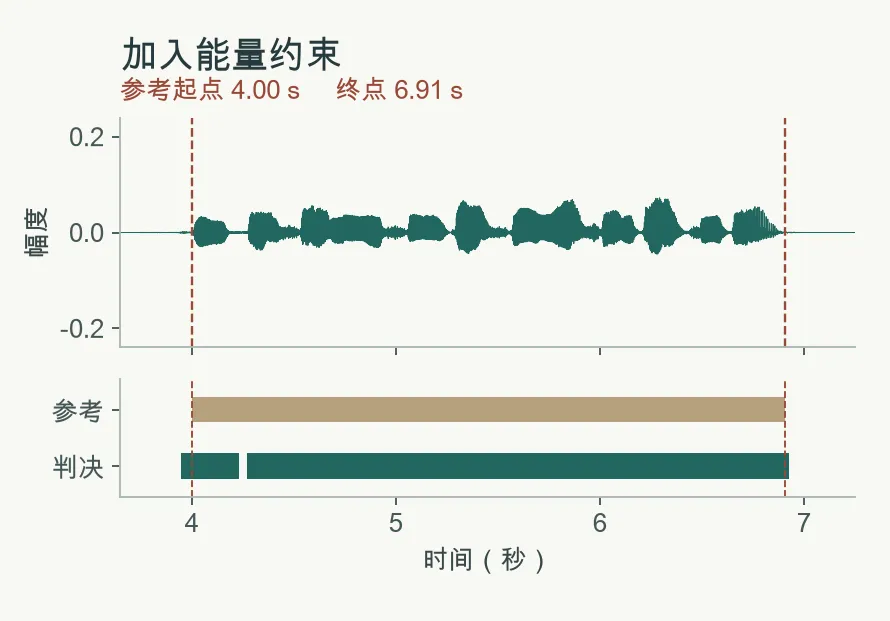
VAD 图里,参考段依据已知语音分量的 10 ms 帧能量划定。两图下方用色带画出检测器判为活动的区间。这句话的参考段从 4.00 s 到 6.91 s。原判决从 3.95 s 连到 6.96 s;加上能量约束,结束点收回到 6.93 s,但 4.23–4.27 s 之间也丢了四帧。 我在增强后的波形上增加了一道逐通道相对能量约束,让已经很安静的帧少触发活动判决;有些弱音也会因此漏掉。
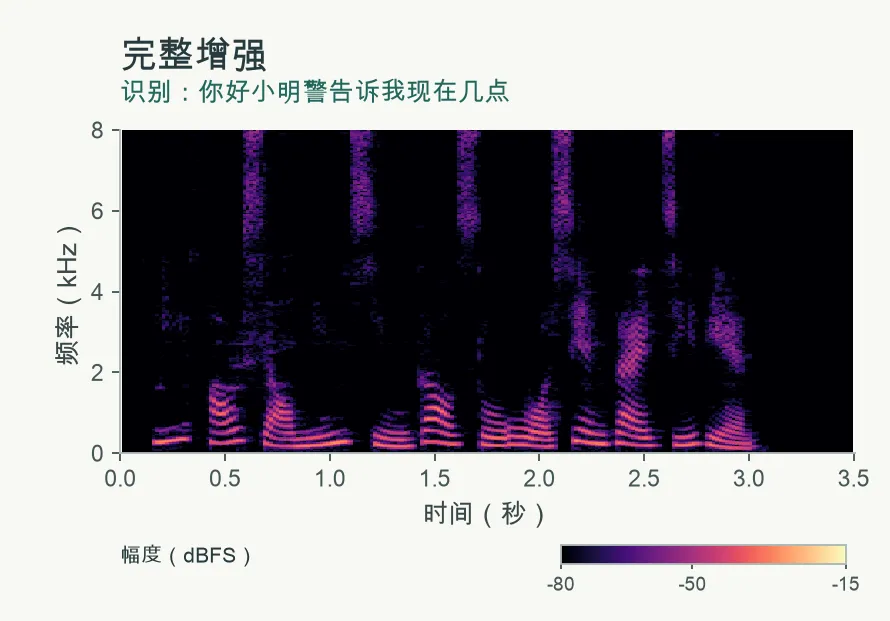
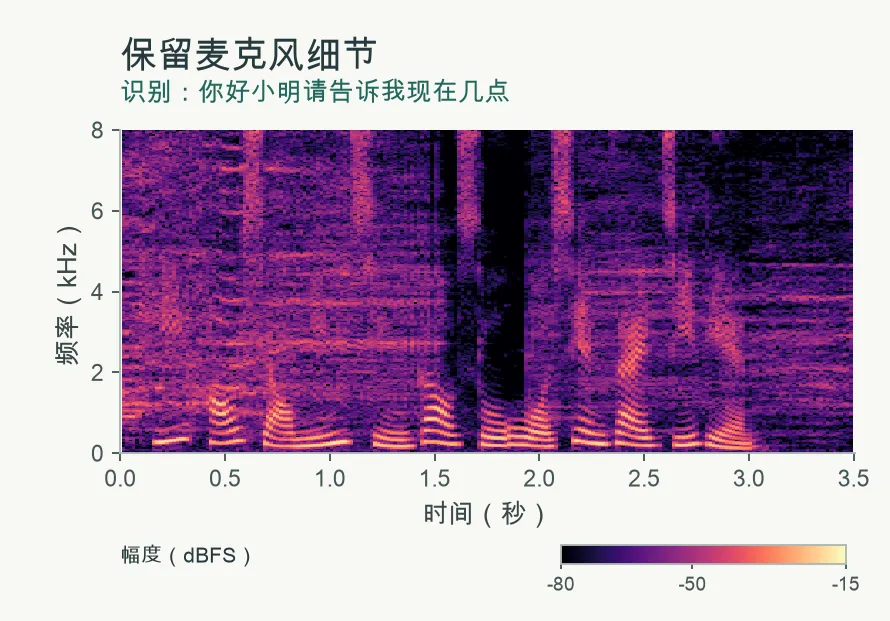
识别这边,我固定分句边界、普通话模型和解码方式,只换送给它的音频。原句是“你好小明请告诉我现在几点”。完整增强的实际结果是“你好小明警告诉我现在几点”,调整识别输入后是“你好小明请告诉我现在几点”。图中时间从送入解码器的片段起点算起。 这组控制句用四种合成音色生成。突发噪声条件下,完整增强的字错率为 45.4%;给识别器保留八成麦克风信号、两成增强信号,再对同一个片段做有界电平调整,字错率降到 37.7%。
SoundField 的第一个正式版本定在 1.0.0,现在放在我的运维项目里。有人拿自己的录音来试,我最想先知道的是采样率、麦克风怎么摆、有没有同步的播放参考,以及声音从哪一秒开始不对。带着这些信息,就能回到那一帧,看看究竟是哪一步把该留下来的声音减掉了。
交流与讨论
评论加载中…