递归最小二乘(RLS)的出发点仍然是最小二乘:用已经观察到的输入和期望输出,寻找累计误差最小的滤波器。不同的是,它不必在每得到一个新样本后重新求解整批数据的正规方程,而是利用上一步的结果递推更新。因此,RLS 通常比简单的随机梯度更新更快地接近当前数据对应的最小二乘解,代价是每个样本要维护一个矩阵,运算量和数值稳定性要求都更高。
RLS 原理
问题描述
考虑长度为 的复数输入向量 、期望输出 和权向量 。在第 个样本处,指数加权目标为
是遗忘因子。取 时,历史样本等权,适合讨论平稳条件下的基本推导;取较小的值时,近期样本权重更高,便于跟踪变化,但估计也更容易受瞬时噪声影响。这里的 是在同一个时刻对整批数据求最优的变量,不能在求导时把求和中的它误写成每个样本各有一组权值。
定义加权输入相关矩阵与互相关向量:
对 求导并令梯度为零,得到正规方程 。当 可逆时,最优权向量为
这一步体现出 RLS 与 LMS/NLMS 的区别:LMS 用当前样本构造随机梯度,沿梯度方向走一步;RLS 维护累计数据对应的二次目标,并通过矩阵递推得到其解。收敛快慢不能脱离输入相关性、遗忘因子、初始化与比较标准作绝对判断,但高度相关输入下,RLS 通常比固定步长 LMS 更少受特征值扩展的影响。
从矩阵求逆引理到递推
新样本到来时,相关量只增加一项:
若每一步都直接求 ,便失去了递归算法的意义。令 ,对新增的秩一项使用矩阵求逆引理,得到
其中 是增益向量。令先验误差为
则权向量更新为
复数情形中的共轭符号必须和输出定义一致:既然输出使用 ,互相关向量就是 ,权值更新项也使用 。实数信号里这些共轭不会显现,照搬到复数语音频域或通信均衡代码时却会出错。
初始化与数值条件
常用初始化是 、,。这等价于在初始相关矩阵里放入 作为正则项。 很小意味着初始逆矩阵很大、算法对早期样本反应很强;过小也可能放大数值误差。它不是越接近零越好,应结合输入幅度和机器精度设置。
每个样本涉及矩阵—向量乘法和矩阵更新,基本 RLS 的计算量与存储量约为 ;LMS 约为 。当滤波器很长或通道很多时,RLS 的收敛优势必须和这部分成本一起衡量。
RLS 应用实例
算法步骤
实现时,每个样本按“先验误差 → 增益 → 逆相关矩阵 → 权向量”的顺序更新。下面的 MATLAB 代码保留这个次序,并把输入长度、遗忘因子和初始化条件明确下来:
function [e, w] = rls_filter(lambda, M, u, d, delta)
    assert(lambda > 0 && lambda <= 1);
    assert(M >= 1 && delta > 0);

    u = u(:);
    d = d(:);
    assert(numel(u) == numel(d));

    N = numel(u);
    e = zeros(N, 1);
    w = zeros(M, 1);
    P = eye(M) / delta;

    for n = M:N
        x = u(n:-1:n-M+1);
        e(n) = d(n) - w' * x;
        k = (P * x) / (lambda + x' * P * x);
        P = (P - k * x' * P) / lambda;
        w = w + k * conj(e(n));
    end
end
对于强相关输入、很长序列或有限精度实现,还要观察 是否保持近似厄米且正定。若数值误差持续积累,可以考虑平方根 RLS 或 QR 分解形式,而不是只凭理论公式判断实现一定稳定。
参考噪声实验
这组演示把干净语音与一段随机噪声相加,再把同一段噪声直接送入自适应滤波器作参考。这个设定能检查 RLS 递推是否正常,却是一个非常理想的参考通道:滤波器实际上已经拿到了与混合信号中噪声完全对应的序列。图中的快速误差下降不等于真实场景下可以取得同样的降噪效果。
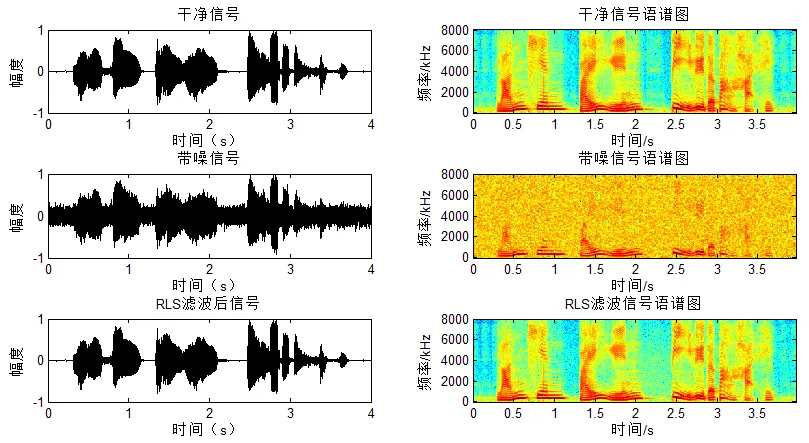
实际自适应降噪至少要满足两点:参考信号与待消除噪声有足够相关性;参考信号不能含有过多目标语音,否则滤波器可能把语音也当成噪声消掉。参考与主通道之间通常还有传播路径,滤波器阶数需要覆盖主要路径长度。若要比较 RLS、LMS 与 NLMS,应该让它们使用相同的参考信号、数据长度和评价区间,并同时报告收敛过程、稳态残差与运算成本。
对比 LMS
RLS 更适合在滤波器阶数可控、环境变化较快且计算资源允许时使用;LMS/NLMS 则更轻量,配置和部署成本低。 时,RLS 累积全部历史数据,若系统后来发生变化,旧数据不会自动退场;此时需要适当减小遗忘因子,或考虑重新初始化。反过来,遗忘因子过小又可能使估计抖动增大。
因此,选择 RLS 的核心理由不应只是“它收敛快”,而是当前问题确实需要用更多计算与存储换取更快的参数跟踪,并且参考信号、滤波器长度和数值精度都能支撑这种选择。
交流与讨论
评论加载中…